اعتماد در محصولات هوش مصنوعی را چگونه با شفافیت، کنترل انسانی، مدیریت خطا، مانیتورینگ و برنامه واکنش به رخداد بسازیم؟ راهنمای اجرایی مدیر محصول.
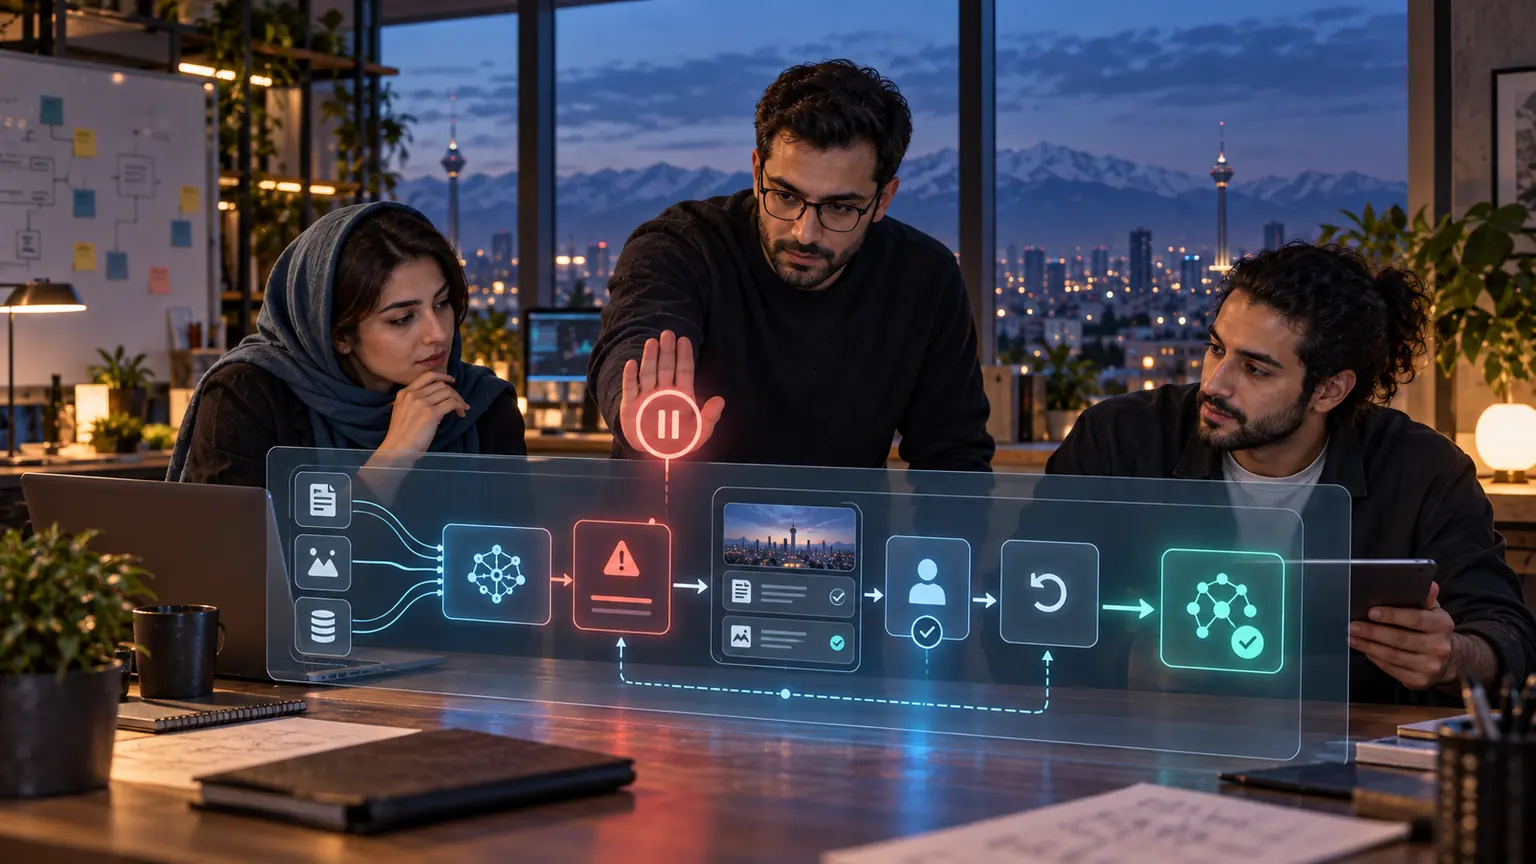
اعتماد در محصولات هوش مصنوعی به این معنا نیست که کاربر همیشه پاسخ AI را بپذیرد. اعتماد سالم یعنی کاربر بداند سیستم در چه کاری توانمند است، شواهد هر خروجی چیست، چه زمانی باید آن را بررسی کند و اگر خطایی رخ داد چگونه بدون آسیب ادامه دهد. محصول قابلاعتماد کاربر را نه به بدبینی دائمی میرساند و نه به اتکای بیش از حد؛ اعتماد را با ریسک هر تصمیم تنظیم میکند.
شفافیت فقط برچسب «ساختهشده با هوش مصنوعی» نیست؛ باید منبع، محدودیت، دامنه مجوز و مسیر اصلاح را در لحظه تصمیم روشن کند. جزئیات رابط در راهنمای طراحی تجربه کاربری محصولات هوش مصنوعی آمده است؛ این مقاله روی سیستم پشت آن تمرکز دارد: قرارداد اعتماد، طبقهبندی خطا، سنجه و واکنش به رخداد.
این راهنما در ۲۹ سپتامبر ۲۰۲۶ با منابع جاری بازبینی شده است. راهنمای شفافیت ماده ۵۰ قانون AI اتحادیه اروپا در ۲۰ ژوئیه ۲۰۲۶ منتشر شد و الزامات مربوط از ۲ اوت ۲۰۲۶ قابلاجرا شدهاند. اگر محصول شما به کاربران اتحادیه اروپا خدمت میدهد، تشخیص تکلیف حقوقی را با متخصص انجام دهید؛ چکلیست این مقاله جای مشاوره حقوقی نیست.
پاسخ روان یا یک صفحه Responsible AI اعتماد نمیسازد. قرارداد اعتماد هر قابلیت را در چهار بخش بنویسید:
1. وعده: سیستم دقیقاً چه کاری را برای چه کاربری و در چه دامنهای انجام میدهد؟
2. شاهد: کاربر و تیم چگونه میفهمند خروجی برای این مورد قابلاتکاست؟
3. کنترل: کدام تصمیم، داده یا اقدام هنوز در اختیار انسان است؟
4. بازیابی: اگر سیستم اشتباه کرد، چگونه اثر خطا متوقف، اصلاح و جبران میشود؟
بهجای وعده مبهم «پاسخگوی هوشمند»، بنویسید: «از اسناد تأییدشده پیشنویس میسازد، منبع را نشان میدهد، بدون تأیید ارسال نمیکند و در نبود شاهد ارجاع میدهد.» حالا هر بخش معیار و تست دارد.
سطح شفافیت و کنترل نباید برای همه خروجیها یکسان باشد. پیش از طراحی، هر سناریو را بر اساس سه پرسش درجهبندی کنید: اگر خروجی غلط باشد چه آسیبی میزند؟ آیا اقدام برگشتپذیر است؟ آیا کاربر فرصت و توان بررسی دارد؟
راهنمای Responsible AI مایکروسافت که ۱۴ ژوئیه ۲۰۲۶ بهروزرسانی شده، پیشنهاد میکند عمق Release Gate با سطح ریسک متناسب باشد و اقدامهای دشوار برای بازگشت یا مؤثر بر انسان، پول و انطباق به تأیید انسانی برسند. «انسان در حلقه» وقتی مفید است که زمینه، زمان و اختیار توقف داشته باشد؛ کلیک تشریفاتی روی تأیید، کنترل انسانی نیست.
کاربر باید بداند با AI تعامل دارد، قابلیت برای چه کاری ساخته شده، به چه دادهای دسترسی دارد و محدودیت مهمش چیست. توضیح را در مسیر اصلی بگذارید و الزامات محلی افشا و نشانهگذاری را بررسی کنید.
هرچه پیامد بیشتر است، خروجی باید قابلبررسیتر باشد. منبع، تاریخ، نسخه یا دامنه داده را نزدیک ادعا نشان دهید. اگر از بازیابی اسناد استفاده میکنید، ارجاع باید به بخش واقعاً پشتیبان پاسخ برسد؛ نه صرفاً صفحهای مرتبط. راهنمای RAG برای مدیر محصول معیارهای Retrieval و پاسخ مستند را توضیح میدهد.
نمایش عدد اطمینان همیشه شفافیت ایجاد نمیکند. ۸۷ درصد بدون خط پایه و بدون اقدام بعدی، فقط دقت ظاهری است. پیامهایی مانند «دو منبع با هم ناسازگارند؛ پیش از ارسال بررسی کنید» یا «سند معتبر برای این ادعا پیدا نشد» اغلب تصمیم بهتری میسازند. راهنمای Explainability و Trust گوگل نیز هدف را اعتماد کالیبره میداند: کاربر بفهمد چه زمانی تکیه کند و چه زمانی قضاوت خود را وارد کند.
برای تصمیم اثرگذار، پیشنهاد AI، تأیید انسان و تغییر نهایی را ثبت کنید. تاریخچه، Undo و مسیر اعتراض بدهید و تغییر مهم مدل یا داده را بیصدا اعمال نکنید.
«نتیجه دقیق نیست» برای مدیریت خطا کافی نیست. تیم باید شکستها را به گونهای دستهبندی کند که هر گروه مالک، سیگنال و پاسخ متفاوت داشته باشد:
تفاوت این دستهها برای اولویتبندی حیاتی است. افزایش Timeout مشکل Hallucination را حل نمیکند و تغییر Prompt مجوز بیش از حد ابزار را اصلاح نمیکند. اگر محصول شما اقدام انجام میدهد، مرز میان AI Agent، چتبات و Automation را روشن کنید تا کنترلها با توان واقعی سیستم هماهنگ باشند.
برای هر سناریوی شکست، از پیش مشخص کنید تیم و محصول تا کجا پیش میروند:
1. اصلاح در لحظه: کاربر ورودی یا خروجی را ویرایش میکند و کارش از بین نمیرود.
2. جایگزین امن: سیستم از حالت خودکار به پیشنهاد، فرم دستی یا جستوجوی معمولی برمیگردد.
3. ارجاع انسانی: مورد همراه با ورودی، منابع، اقدامهای انجامشده و دلیل ارجاع منتقل میشود؛ کاربر مجبور نیست از اول توضیح دهد.
4. محدودسازی: یک ابزار، گروه کاربر، نوع درخواست یا منطقه موقتاً غیرفعال میشود.
5. Rollback یا Kill Switch: نسخه مدل، Prompt، Retrieval یا کل قابلیت به آخرین وضعیت امن بازمیگردد.
هر پله باید مالک و زمان پاسخ داشته باشد. اگر فقط تیم مهندسی Kill Switch را میشناسد اما پشتیبانی راه تشخیص رخداد را ندارد، برنامه روی کاغذ مانده است.
چارچوب مدیریت ریسک AI در NIST مدیریت ریسک را در طراحی، توسعه، استفاده و ارزیابی دنبال میکند. تا سپتامبر ۲۰۲۶، AI RMF 1.0 در حال بازنگری است و پروفایل رسمی GenAI موجود همان نسخه منتشرشده در ژوئیه ۲۰۲۴ است. پیام عملی برای مدیر محصول روشن است: ارزیابی پیش از عرضه کافی نیست؛ باید رفتار تولید را مشاهده و برای رخداد آماده شوید.
Runbook شما دستکم این موارد را داشته باشد:
نمره رضایت یا تعداد استفاده بهتنهایی قابلاعتمادبودن را نشان نمیدهد. داشبورد متعادل را در چهار لایه بسازید:
سنجهها را بر اساس زبان، گروه کاربر، نوع کار و نسخه سیستم بخشبندی کنید؛ میانگین کل میتواند شکست یک گروه کوچک اما پرریسک را پنهان کند. برای ساخت دیتاست و آستانههای Release Gate از راهنمای طراحی Eval محصولات هوش مصنوعی استفاده کنید.
فرض کنید AI بندهای پرریسک قرارداد را برای تیم فروش خلاصه میکند. نسخه ضعیف یک پاسخ روان و یک هشدار عمومی «ممکن است خطا کند» میدهد. نسخه قابلاعتماد دامنه را به قراردادهای استاندارد محدود میکند، هر ادعا را به شماره بند وصل میکند و تاریخ نسخه سیاست حقوقی را نشان میدهد.
اگر سند ناقص یا خارج از دامنه باشد، سیستم بند ناشناخته را علامت میزند و پرونده را با زمینه به حقوقی ارجاع میدهد. اقدام بدون تأیید انجام نمیشود و داده حساس بیش از نیاز نمیماند.
Release Gate فقط «دقت ۹۰ درصد» نیست؛ جاافتادن بند مسئولیت نامحدود آستانه سختتری دارد. با افزایش خطای بحرانی، قابلیت به نمایش منابع محدود و نسخه امن بازگردانده میشود.
اعتماد با پنهانکردن عدمقطعیت ساخته نمیشود؛ با وعده محدود، شاهد قابلبررسی، کنترل متناسب و بازیابی قابلاتکا ساخته میشود. مدیر محصول باید تجربه خوب و عملیات ایمن را یک سیستم ببیند: از متن افشا و ارجاع گرفته تا Eval، مانیتورینگ، Incident Response و Rollback.
از یک قابلیت و یک سناریوی شکست شروع کنید. قرارداد اعتماد را بنویسید، بازیابی را تمرین کنید و معیار توقف را پیش از فشار رخداد تعیین کنید. اگر میخواهید این چارچوب را به PRD و برنامه عرضه تیم خود تبدیل کنید، مسیر هوش مصنوعی در ساخت محصول و منتورینگ مدیریت محصول قدمهای بعدی مناسبی هستند.
