RAG چیست، چگونه کار میکند و مدیر محصول برای تعریف مسئله، طراحی تجربه، ارزیابی کیفیت، کنترل ریسک و عرضه یک محصول مبتنی بر RAG چه باید بداند؟
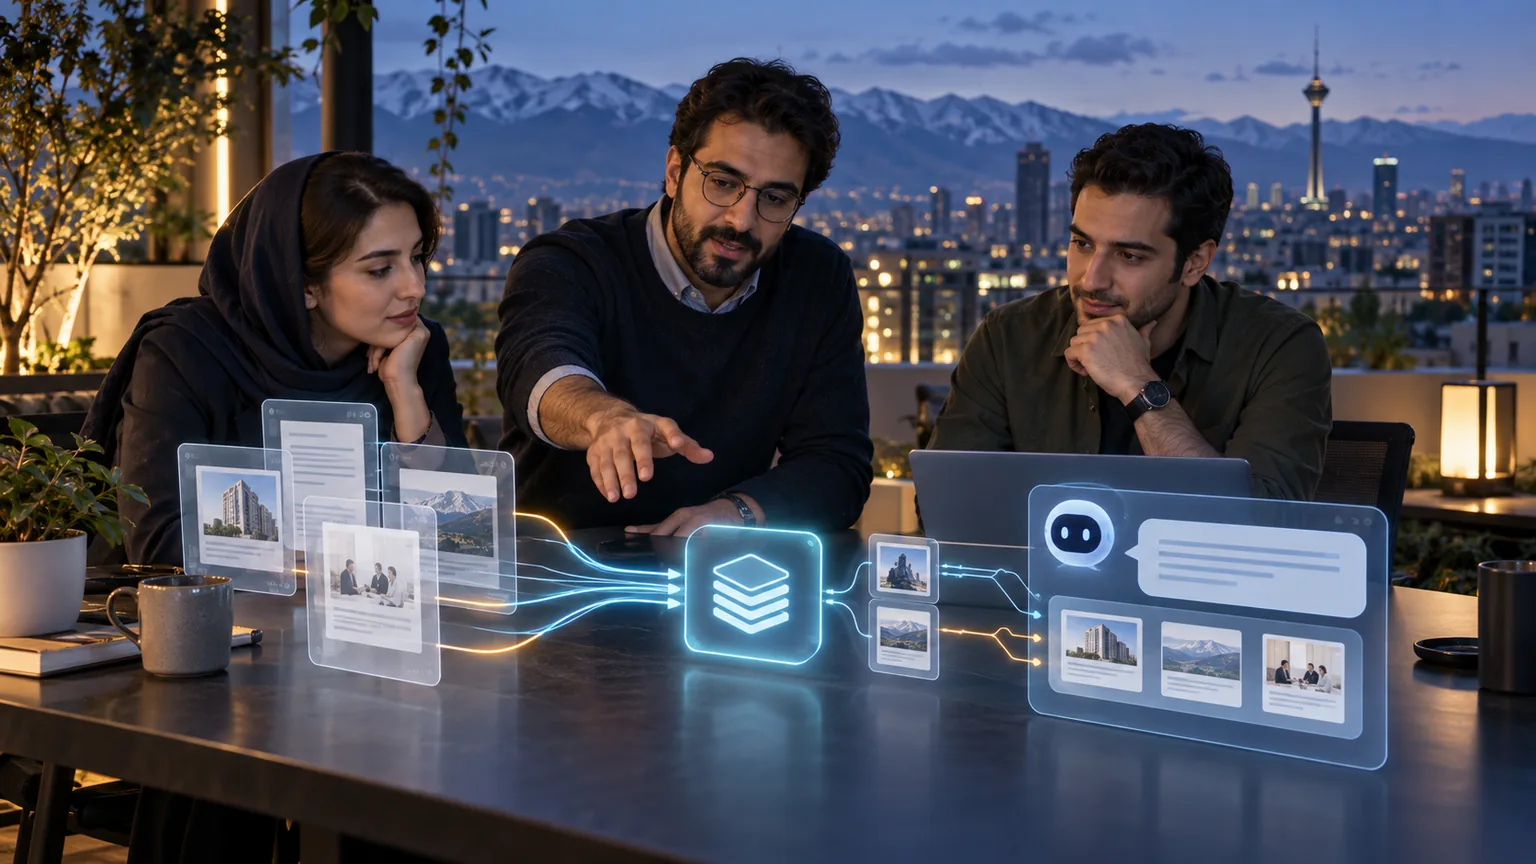
RAG مخفف Retrieval-Augmented Generation یا «تولید تقویتشده با بازیابی» است. در این الگو، محصول پیش از ساخت پاسخ، اطلاعات مرتبط را از یک منبع بیرونی پیدا میکند و همراه پرسش در اختیار مدل زبانی میگذارد. مدل بهجای تکیه صرف بر دانشی که هنگام آموزش در پارامترهایش ذخیره شده، با زمینهای تازه، خصوصی یا تخصصی پاسخ میدهد.
تصور کنید کاربر میپرسد: «شرایط بازپرداخت پلن سازمانی چیست؟» یک چتبات عادی ممکن است براساس الگوهای عمومی حدس بزند. سامانه RAG ابتدا در قراردادها و راهنمای بهروز شرکت جستوجو میکند، چند بخش مرتبط را برمیگرداند و سپس پاسخی همراه منبع میسازد. تفاوت محصولی مهم همین است: پاسخ باید به شواهد قابلردیابی وصل باشد.
مقاله اصلی Retrieval-Augmented Generation در سال ۲۰۲۰، حافظه پارامتری مدل را با حافظه غیرپارامتری قابلبازیابی ترکیب کرد. امروز این ایده در جستوجوی سازمانی، پشتیبانی، دستیار فروش، تحلیل اسناد و محصولات دانشمحور استفاده میشود. این راهنما در ۲۷ سپتامبر ۲۰۲۶ با مستندات جاری بازبینی شده است.
یک جریان استاندارد را میتوان در دو مسیر دید: آمادهسازی دانش و پاسخ به درخواست.
در مسیر آمادهسازی، فایلها و رکوردها جمعآوری، پاکسازی و به قطعههای کوچکتر یا Chunk تقسیم میشوند. هر قطعه همراه فرادادهای مثل منبع، تاریخ، محصول، زبان و سطح دسترسی ذخیره میشود. معمولاً از Embedding برای تبدیل معنا به بردار و از یک Vector Store برای جستوجوی مشابهت استفاده میشود؛ اما جستوجوی کلیدواژهای، فیلتر و رتبهبندی دوباره نیز میتوانند کنار آن باشند.
در مسیر پاسخ، این اتفاقها رخ میدهد:
1. کاربر سؤال یا وظیفه را وارد میکند؛
2. سیستم در صورت نیاز سؤال را بازنویسی و محدودیت دسترسی را اعمال میکند؛
3. Retriever چند قطعه مرتبط را پیدا میکند؛
4. Reranker بهترین شواهد را بالاتر میآورد؛
5. سؤال، دستور و شواهد منتخب به مدل میرسد؛
6. مدل پاسخ، ارجاع یا اعلام «اطلاعات کافی نیست» را تولید میکند؛
7. سیستم رخدادها و بازخورد را برای ارزیابی ثبت میکند.
راهنمای Retrieval در OpenAI توضیح میدهد که جستوجوی معنایی میتواند نتیجه مرتبطی را حتی بدون واژههای مشترک پیدا کند و فایلهای Vector Store بهصورت خودکار قطعهبندی، Embedding و ایندکس میشوند. برای مدیر محصول، عددهای پیشفرض ابزار «حقیقت معماری» نیستند؛ اندازه Chunk، تعداد نتایج و آستانه رتبهبندی باید با داده واقعی محصول آزمایش شوند.
RAG مدل تازهای نیست و معمولاً وزنهای مدل پایه را تغییر نمیدهد. Fine-tuning بیشتر برای تغییر رفتار، سبک، قالب یا یادگیری الگوی وظیفه مناسب است؛ RAG برای آوردن دانش قابلبهروزرسانی در لحظه پاسخ. این دو میتوانند مکمل هم باشند.
RAG همچنین مترادف Vector Database نیست. پایگاه برداری فقط یکی از اجزای بازیابی است. برای کد محصول، شناسه خطا یا نام دقیق یک پلن، جستوجوی کلیدواژهای ممکن است بهتر باشد. جستوجوی Hybrid اغلب واژه و معنا را ترکیب میکند. از طرف دیگر، قرار دادن کل یک سند در Context هم لزوماً RAG نیست؛ هزینه و تأخیر بالا میرود و اطلاعات مهم میان متن گم میشود.
مهمتر از همه، RAG «توهم را حذف» نمیکند. اگر سند نادرست یا قدیمی باشد، Retriever شاهد نامرتبط برگرداند یا مدل از Context فراتر برود، پاسخ همچنان خطا دارد. RAG احتمال پاسخ مستند را بالا میبرد؛ تضمین حقیقت نیست.
پیش از افزودن RAG، مسئله را با یک سؤال محصولی شروع کنید: «کاربر برای انجام کدام تصمیم به چه دانشی نیاز دارد که مدل بهتنهایی در اختیار ندارد؟» RAG معمولاً ارزشمند است وقتی:
اما اگر مسئله با جستوجوی ساده و نمایش سند حل میشود، تولید متن شاید ارزش اضافه نکند. اگر داده مرجع پراکنده، متناقض و بدون مالک است، ابتدا حاکمیت محتوا را درست کنید. اگر کاربر پاسخ خلاق میخواهد نه دانش سازمانی، RAG ممکن است پیچیدگی بیدلیل بسازد. و اگر نتیجه مستقیماً عمل پرریسکی انجام میدهد، بازیابی فقط یک لایه است؛ مجوز، تأیید انسانی و قواعد قطعی هنوز ضروریاند. برای تشخیص مرز اجرای خودکار، تفاوت AI Agent، چتبات و Automation را ببینید.
معماری را مهندسی میسازد، اما پنج تصمیم زیر مستقیماً محصولیاند.
مشخص کنید محصول چه نوع سؤالی را جواب میدهد، به چه سؤالی نباید جواب دهد و در نبود شواهد چه میگوید. آیا پاسخ باید نقلقول و لینک منبع داشته باشد؟ آیا اختلاف دو سند را نشان میدهد یا یکی را انتخاب میکند؟ چه زمانی کاربر به کارشناس منتقل میشود؟ یک جمله محترمانه «منبع کافی پیدا نکردم» اغلب بهتر از پاسخ روان و ساختگی است.
از «همه اسناد شرکت» شروع نکنید. یک دامنه باریک با نتیجه قابلاندازهگیری انتخاب کنید؛ مثلاً راهنمای عیبیابی سه محصول پرتکرار. برای هر منبع، مالک، نسخه، تاریخ انقضا، زبان، مخاطب و سطح دسترسی تعریف کنید. پاسخ خوب از محتوای بد ساخته نمیشود.
ارجاع را بخشی از رابط کاربری ببینید، نه تزئین انتهای متن. کاربر باید عنوان منبع، بخش استفادهشده و تاریخ بهروزرسانی را ببیند و با یک کلیک به سند برسد. بین متن پاسخ و شواهد باید ارتباط روشن باشد. اگر منابع اختلاف دارند، محصول باید اختلاف را آشکار کند. در موضوع حساس، سطح اطمینان و مسیر اصلاح پاسخ را نیز نشان دهید.
مجوز باید پیش از بازیابی اعمال شود، نه پس از تولید پاسخ. اگر کاربر اجازه دیدن فایل حقوق و دستمزد را ندارد، آن فایل نباید وارد نتایج Retriever یا Context مدل شود. داده شخصی، اسرار تجاری، محل پردازش، مدت نگهداری و حذف داده را در Discovery روشن کنید. اسناد ورودی نیز ممکن است حاوی دستور مخرب باشند؛ متن بازیابیشده باید «داده» تلقی شود، نه فرمان معتبر برای سیستم.
هر پاسخ هزینه مدل، جستوجو، ذخیرهسازی و مشاهدهپذیری دارد. کیفیت را کنار P50 و P95 تأخیر، هزینه هر پاسخ موفق، نرخ Cache و نرخ انتقال به انسان ببینید. استفاده از مدل بزرگتر برای همه درخواستها ممکن است کیفیت کمی بهتر و اقتصاد محصول را بسیار بدتر کند. مسیرهای ساده را با Search یا مدل ارزانتر حل کنید و ظرفیت گرانتر را برای سؤال دشوار نگه دارید.
ارزیابی RAG باید Retriever و پاسخ نهایی را جداگانه بسنجد. اگر سند درست بازیابی نشده باشد، تغییر پرامپت یا مدل فقط نشانه را پنهان میکند. اگر سند درست حاضر است اما پاسخ غلط است، مسئله در Generation، دستور یا نحوه استفاده از Context قرار دارد.
یک دیتاست ارزیابی از سؤالهای واقعی بسازید و نمونههای آسان، مبهم، چندمرحلهای، بدون پاسخ، دارای اصطلاح فارسی و انگلیسی، و نیازمند سطح دسترسی متفاوت را پوشش دهید. برای هر سؤال، سند یا بخش معتبر، پاسخ مورد انتظار و رفتار مطلوب در نبود شواهد را ثبت کنید. راهنمای طراحی Eval برای محصولات هوش مصنوعی روش ساخت دیتاست و خط پایه را کاملتر توضیح میدهد.
چهار لایه متریک داشته باشید:
راهنمای ارزیابهای RAG در Microsoft Foundry نیز کیفیت Retrieval را از Groundedness، Relevance و Response Completeness جدا میکند. یک امتیاز تجمیعی بهتنهایی کافی نیست؛ ممکن است پاسخ بسیار مستند اما بیربط، یا مرتبط اما ناقص باشد.
در کنار ارزیابی آفلاین، بازبینی انسانی و آزمایش آنلاین لازم است. نرخ رضایت بدون نمونهخوانی فریبنده است؛ کاربر ممکن است به پاسخ خوشنویس امتیاز مثبت بدهد، در حالی که منبع آن را پشتیبانی نمیکند. شکستها را به دستههایی مانند «سند موجود نبود»، «بازیابی نشد»، «منبع قدیمی بود»، «مدل از منبع عبور کرد» و «رابط اعتماد نساخت» تقسیم کنید تا هر تیم صاحب اقدام مشخصی باشد.
فرض کنید تیم میخواهد زمان پاسخ پشتیبانی را کاهش دهد. هدف مبهم «ساخت چتبات RAG» نیست؛ Outcome میتواند «کاهش زمان رسیدن کاربر به پاسخ معتبر برای پنج مسئله پرتکرار، بدون افزایش پاسخ اشتباه» باشد.
MVP فقط راهنماهای تأییدشده همان پنج مسئله را ایندکس میکند. هر سند مالک و تاریخ بازبینی دارد. پاسخ فقط با حداقل یک شاهد معتبر نمایش داده میشود؛ در نبود شاهد، سیستم سؤال روشنکننده میپرسد یا تیکت میسازد. کاربران داخلی پشتیبانی ابتدا آن را در حالت Copilot آزمایش میکنند، نه پاسخگوی خودکار مشتری.
تیم پنجاه سؤال واقعی و ده سؤال بدون پاسخ میسازد. برای هر نسخه، Recall بازیابی، Groundedness، کاملبودن، تأخیر و هزینه را میسنجد. سپس دو هفته Shadow Mode اجرا میکند: پاسخ تولید میشود اما فقط کارشناس آن را میبیند و تأیید یا اصلاح میکند. پس از عبور از آستانهها، یک گروه کوچک مشتری پاسخ همراه منبع دریافت میکند. بازخوردهای متنی این گروه را میتوان با روش تحلیل مصاحبههای کاربر با هوش مصنوعی کدگذاری کرد، بدون آنکه داده خام حساس به ابزار نامطمئن داده شود.
پروفایل ریسک GenAI در NIST بر مستندسازی نحوه انطباق مدل، از جمله RAG، و پایش مداوم سامانه تأکید میکند. برای PRD، رجیستر ریسک را به کنترل قابلآزمون تبدیل کنید: چه کسی منبع را تأیید میکند، مجوز کجا اعمال میشود، لاگ چه چیزی را ثبت نمیکند، و پاسخ نامطمئن چگونه متوقف میشود.
برای مدیر محصول، پاسخ «RAG چیست» فقط یک دیاگرام فنی نیست. RAG یک سیستم محصولی شامل محتوا، Retrieval، مدل، رابط اعتماد، مجوز و چرخه ارزیابی است. مزیت آن دسترسی به دانش تازه و قابلردیابی است؛ محدودیتش این است که کیفیت هیچ حلقهای را خودکار تضمین نمیکند.
از دامنهای کوچک و منبعی تمیز شروع کنید، قرارداد پاسخ و خودداری را بنویسید، Retrieval را جداگانه ارزیابی کنید و اثر واقعی بر کار کاربر را بسنجید. اگر برای تبدیل این تصمیمها به PRD و برنامه عرضه نیاز به همراهی دارید، منتورینگ مدیریت محصول در دسترس است؛ برای سنجش آمادگی خود نیز میتوانید از خودارزیابی مهارتهای محصول شروع کنید.
